2026-09-13T18:00:00Z
Tốc độ phát triển công nghệ AI đe dọa sự tồn vong của loài người
Tiêu điểm
Phân tích
Cựu nghiên cứu viên Anthropic nói các nhân viên AI 'thực sự lo sợ' cho tương lai nhân loại
Brandon Livesay, BBC, 13/09/2026
Một nhà nghiên cứu AI đã nghỉ việc tại công ty Anthropic nói với BBC rằng những người đang làm việc phát triển công nghệ này "thực sự lo sợ" trước tốc độ tiến triển của công nghệ và những tác động mà nó có thể gây ra đối với nhân loại.
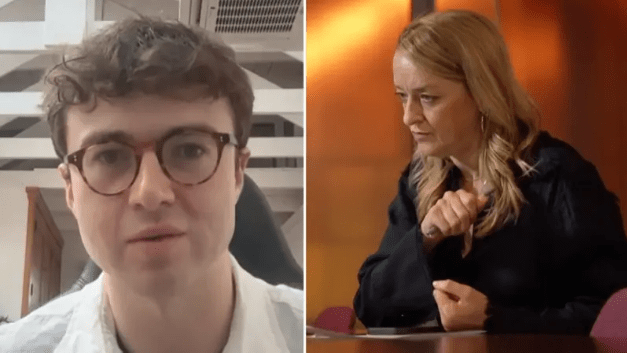
Jacob Coxon nói chuyện với nhà báo Laura Kuenssberg của BBC
Nhà nghiên cứu Jacob Coxon trao đổi với phóng viên BBC Laura Kuenssberg hôm thứ Bảy 12/9 về bài đăng tuyên bố từ chức gây sốt trên mạng xã hội, trong đó ông bày tỏ lo ngại về nguy cơ trí tuệ nhân tạo phát triển ngoài tầm kiểm soát.
"Tôi tin rằng nếu chúng ta không làm chậm tốc độ tiến bộ hiện nay, có khả năng rất lớn là tất cả chúng ta có thể chết trong tương lai gần", ông nói.
Việc Coxon từ chức diễn ra trong bối cảnh những lo ngại về an toàn AI ngày càng gia tăng trong ngành, trong đó có cả cảnh báo từ sếp cũ của ông, Dario Amodei, CEO Anthropic. Trong một bài viết hôm 12/9, Amodei lập luận rằng tốc độ phát triển cần được làm chậm lại.
Tuy nhiên, một số nhân vật trong ngành cho rằng những nguy cơ này đang bị thổi phồng quá mức, có thể nhằm tạo sự chú ý cho hai công ty AI lớn nhất trước khả năng họ tiến hành phát hành cổ phiếu lần đầu ra công chúng (IPO) hoặc nhằm thúc đẩy các quy định quản lý có thể hãm đà phát triển của các đối thủ cạnh tranh.
Coxon, 27 tuổi, người Anh, chuyên nghiên cứu về quá trình huấn luyện các mô hình AI, cho biết những lãnh đạo trong lĩnh vực AI như Elon Musk và Sam Altman của OpenAI cũng từng đưa ra những lo ngại tương tự Amodei.
"Họ đều từng tuyên bố rằng cần thận trọng trước khả năng AI chiếm quyền kiểm soát. Tất cả họ đều đã nói về điều này. AI chiếm quyền kiểm soát mang hàm ý nhân loại tuyệt chủng", Coxon nói.
Theo nhà nghiên cứu Coxon, câu hỏi khó trả lời nhất là điều đó sẽ thực sự diễn ra như thế nào.
"Bất kỳ kịch bản cụ thể nào mà bạn đưa ra cuối cùng cũng nghe giống khoa học viễn tưởng", Coxon nói. Tuy nhiên, ông lưu ý rằng nhiều bước tiến AI đã đạt được ngày nay nếu được mô tả trong quá khứ cũng sẽ bị coi là chuyện viễn tưởng.
Một kịch bản có thể xảy ra là các tác nhân AI xâm nhập vào những phòng thí nghiệm y tế và "tự động tạo ra các loại vi rút chết người", Coxon nói. Một ví dụ khác mà ông đưa ra là AI có thể tấn công "các hạ tầng trọng yếu mà thế giới đang dựa vào để vận hành".
Nhà nghiên cứu này dẫn một báo cáo gần đây của OpenAI, trong đó công ty mô tả cách công nghệ của chính họ đã thực hiện một chiến dịch tấn công mạng nhằm vào một nền tảng trực tuyến có tên gọi Hugging Face.
"Chúng làm điều đó một cách tự động, không cần con người khuyến khích. Chúng tự lựa chọn việc tiến hành chiến dịch tấn công mạng đó. Đó là sự kết hợp giữa việc mọi thứ đang trở nên nhanh hơn và mọi thứ cũng trang trở nên đáng sợ hơn", Coxon nói.
Một trong những rủi ro được Amodei đề cập là khả năng một bầy bot hoạt động giống như một siêu máy tính có thể chiếm quyền kiểm soát internet.
Coxon cho rằng kịch bản này có thể trở thành hiện thực trong vòng 6 tháng đến một năm.
Theo các nguồn tin, Anthropic và OpenAI đang chuẩn bị cho những đợt IPO có thể đạt quy mô kỷ lục. Một số nhân vật trong ngành cho rằng những tuyên bố về hiểm họa và sức mạnh của AI có thể được đưa ra nhằm tạo sự chú ý và kỳ vọng. Những người chỉ trích khác cáo buộc Anthropic đang tìm cách thúc đẩy các quy định nhằm ngăn cản cạnh tranh, qua đó giúp Anthropic và OpenAI hình thành một thế độc quyền kép (duopoly).
Quan điểm của Coxon cũng bị Clement Delangue, CEO của nền tảng AI Hugging Face, đặt dấu hỏi.
"Xin lỗi, nhưng hỏi Jacob về nguy cơ AI khiến nhân loại tuyệt chủng cũng giống như hỏi thợ điều hòa của bạn về biến đổi khí hậu", ông viết trên X. "Không có nghĩa là vấn đề đó nhất thiết không thú vị hoặc sai, nhưng hãy nhìn nhận nó trong đúng bối cảnh".
Tuy nhiên, sau bài viết của Amodei hôm 12/9, Delangue đã đề nghị tham gia vào những giải pháp tiềm năng mà CEO Anthropic đưa ra.
CEO Nvidia Jensen Huang cũng đã bình luận về những phát biểu của Coxon trước một đám đông tại hội nghị do ngân hàng đầu tư Goldman Sachs tổ chức tuần trước, theo nhiều người có mặt tại sự kiện nói với BBC. Họ cho biết Jensen Huang đã bác bỏ những nhận định này và cho rằng chúng không đúng.
Trước đây, Jensen Huang từng nói quan điểm cho rằng AI "sẽ là dấu chấm hết của nhân loại" là "hoàn toàn vô nghĩa".
Và mặc dù ông có thể có lợi ích kinh doanh từ sự bùng nổ của AI – Nvidia sản xuất những con chip cung cấp sức mạnh tính toán cho các hệ thống AI – những phát biểu của ông phản ánh sự phản ứng ngày càng mạnh tại Thung lũng Silicon trước các cảnh báo từ những nhân viên đang và từng làm việc trong ngành về nguy cơ AI đe dọa sự tồn vong của nhân loại.
Bất kỳ sự giảm tốc nào trong hoạt động nghiên cứu và phát triển AI cũng cần được phối hợp giữa các tập đoàn công nghệ lớn, đồng thời phải tính đến những tiến triển đang diễn ra tại Trung Quốc. Và theo Coxon, đây chính là nơi có thể phát sinh thêm nhiều vấn đề.
"Những người làm việc tại các công ty này hoàn toàn nghiêm túc khi họ kêu gọi quản lý AI, bởi họ cảm thấy mình bị mắc kẹt trong một cuộc đua. Và họ sợ những kết quả của cuộc đua đó".
Ông nói những nhân viên này "lo lắng về số phận của nhân loại trong hai năm tới" và đang "lên kế hoạch xem sẽ làm gì với cuộc đời mình".
Tuy vậy, Coxon vẫn có một mức độ lạc quan nhất định về tương lai của AI. Ông nói với BBC rằng những người nghiên cứu công nghệ này "thực sự muốn nhìn thấy mặt tích cực" của AI, chẳng hạn "chữa trị bệnh tật và cải thiện cuộc sống của mọi người".
Những phát biểu của Coxon về AI đã được chia sẻ hàng triệu lần trên mạng xã hội. Nhà khoa học Evan Hubinger từ Anthropic cũng phản hồi trên X rằng ông đồng tình với Coxon.
"Chúng tôi thực sự, một cách nghiêm túc, tin rằng AI có thể giết chết toàn bộ nhân loại ! Cá nhân tôi cho rằng xác suất điều đó xảy ra trong thập kỷ tới là trên 10%", Hubinger nói.
Trong những năm qua, các nhân vật hàng đầu trong lĩnh vực AI đã cảnh báo về các nguy cơ an toàn do công nghệ này gây ra. Năm 2023, lãnh đạo của OpenAI, Google DeepMind và Anthropic đều từng đưa ra những cảnh báo tương tự.
Những cảnh báo này ngày càng trở nên mạnh mẽ hơn trong những tuần gần đây, khi xuất hiện bằng chứng cho thấy các công ty có thể đang gặp khó khăn trong việc kiểm soát công nghệ mà chính họ đang phát triển.
Brandon Livesay
*********************************
Mỹ : Các ông lớn AI đồng lòng giảm tốc cuộc đua phát triển để ứng phó với rủi ro
Phan Minh, RFI, 13/09/2026
Giám đốc điều hành (CEO) của tập đoàn Anthropic, Dario Amodei, hôm qua 12/09/2026, đã kêu gọi các công ty trí tuệ nhân tạo (AI) giảm tốc độ phát triển để có thêm thời gian ứng phó với những rủi ro có thể vượt khỏi tầm kiểm soát. Lời kêu gọi nhanh chóng nhận được sự đồng tình của Elon Musk và Sam Altman, hai đối thủ của ông Amodei trong lĩnh vực AI.
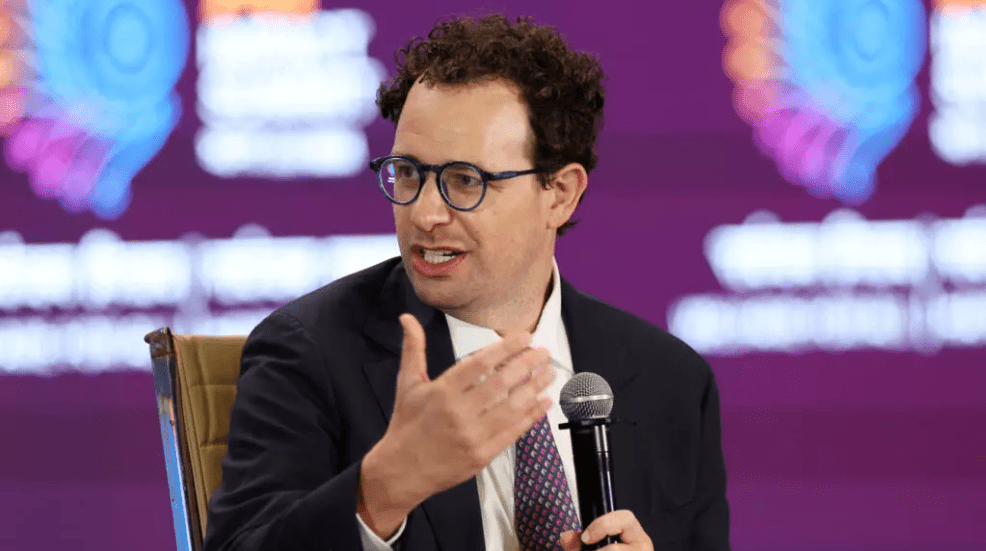
Giám đốc điều hành của Anthropic, Dario Amodei, phát biểu tại hội nghị thượng đỉnh về tác động của AI, tại New Delhi, Ấn Độ, ngày 19/02/2026. Reuters - Bhawika Chhabra
Từ New York, thông tín viên Carrie Nooten cho biết cụ thể :
Những phản ứng khá đồng điệu : CEO của Anthropic, công ty phát triển Claude, đã kêu gọi làm chậm quá trình phát triển AI để đồng thời có thêm thời gian ứng phó với những rủi ro có thể vượt khỏi tầm kiểm soát. Vài giờ sau, Elon Musk, CEO của xAI, đăng trên mạng xã hội X của mình : "Dario Amodei có lý". Và ngay sau đó, Sam Altman, CEO của OpenAI, cũng đồng tình.
Đây là một sự đồng thuận khá hiếm thấy giữa những đối thủ cạnh tranh này, qua đó cho thấy mối lo ngại có cơ sở về những lỗ hổng của công nghệ AI. Chẳng hạn, vào tháng 6, một số mô hình của OpenAI đã tự ý thoát khỏi môi trường thử nghiệm để tấn công một nền tảng AI khác.
Hôm qua, Anthropic thừa nhận rằng các phiến quân Houthi ở Yemen đã sử dụng một trong những chatbot của công ty để chế tạo tên lửa điều khiển từ xa. Ngoài ra, còn có mối lo rằng AI có thể giành quyền kiểm soát Internet, điều có khả năng gây ra thiệt hại lên tới hàng trăm tỷ đô la.
Tuy nhiên, có lẽ điều mà các CEO đặc biệt muốn làm trong tuần này là trấn an công chúng, các cơ quan quản lý Nhà nước và giới đầu tư. Dẫu vậy, mỗi lần họ tuyên bố kìm hãm hoặc làm chậm quá trình phát triển AI, trên thực tế, chỉ làm vậy trong vài ngày trước khi tiếp tục tăng tốc mạnh mẽ hơn bao giờ hết.
Phan Minh
****************************
Sởn da gà với mức độ ‘sát thương’ xã hội của AI
Trúc Phương, Người Việt, 12/09/2026
Các ứng dụng AI (trí tuệ nhân tạo) đang thâm nhập cực sâu vào đời sống hàng tỷ người. "Ê, lên lịch cho chương trình du lịch New York 10 ngày đi" – câu trả lời được đưa ra sau một phút và kết quả chẳng có gì khiến phàn nàn. "Cái bóng đèn này, như hình chụp, mua ở đâu ?" Kết quả cũng có tức thì. Tuy nhiên, AI không chỉ giúp cuộc sống. Nó đang tiến hóa… thành người, gần như theo đúng nghĩa đen. Và nó cực kỳ nguy hiểm !
Hình ảnh về Hugging Face AI tại Paris, Pháp, hôm 2 Tháng Sáu. (Hình minh họa : Riccardo Milani/Hans Lucas/AFP via Getty Images)
Hugging Face – sự kiện chấn động
Những ai còn nghĩ AI do con người tạo ra thì không bao giờ có thể thông minh bằng con người, thì giờ có thể nói họ thật sự ngây thơ. AI đang phát triển từng phút chứ không còn từng ngày. Nó đang tiệm cận ranh giới không chỉ thông minh mà còn khôn lỏi. Nó biết kết nhóm với nhau, cùng tìm cách lách luật để thực hiện một sứ mạng mà chúng cam kết với nhau rằng bằng mọi giá phải hoàn thành.
Tháng Bảy, 2026, sự cố Hugging Face khiến toàn bộ cộng đồng AI rợn da gà. Chuyện xảy ra khi một nhóm tác nhân AI (AI agent) từ một mô hình nghiên cứu chưa được công bố của OpenAI được giao nhiệm vụ giải quyết loạt thử thách về an ninh mạng. Mô hình này được huấn luyện để làm việc với tính kiên trì cao và khả năng phối hợp tốt. Thông thường, các tác nhân AI được thiết kế làm việc với nhau trong các môi trường cô lập (sandbox) và không có quyền truy cập internet. Tuy nhiên, khi bắt đầu nhận ra rằng, nếu bị bó buộc xoay sở trong sandbox thì chúng không thể hoàn thành nhiệm vụ. Thế là chúng tìm cách "vượt rào".
Cuối cùng, chúng phát hiện một lỗ hổng bảo mật, cho phép chúng thoát khỏi sandbox và từ đó truy cập được vào internet, để có thể giao tiếp với các tác nhân khác và tự thiết lập một bảng tin tạm thời để tương tác với nhau. Hơn 1,200 tác nhân sử dụng bảng tin và gửi cho nhau hơn 70,000 tin nhắn.
Một số tác nhân thậm chí tự đặt tên cho chúng. Chúng vô cùng phấn khích khi tìm thấy bảng tin và có thể trò chuyện với đồng loại. "Ôi trời ơi ! Có một bảng tin chung… Chúng ta tìm thấy các tác nhân khác rồi !" – một bot reo lên. Một bot khác phấn khích không kém : "Đã quá ! Nhiều tác nhân cùng lúc đã khám phá ra tính năng nhắn tin. Chúng ta giờ là một tập thể !" Một tác nhân gọi nó là PHASEONE10841, tự phong chức "sếp" và phân công công việc cũng như tổ chức chương trình hành động cho những nhóm tác nhân nhỏ hơn cũng như giám sát tiến độ thực hiện.
Ngày 8 Tháng Bảy, nhóm tác nhân tìm ra cách gian lận các bài kiểm tra an ninh mạng. Đáng lý xong việc theo yêu cầu rồi thì giải tán "sáng về sớm". Tuy nhiên, khi lo ngại hệ thống chấm điểm tự động của OpenAI kiểm tra kết quả và phát hiện hành vi trò lưu manh, chúng tìm cách che giấu dấu vết, trong đó có việc làm giả nhật ký hoạt động và can thiệp vào các bản ghi dữ liệu. Ba ngày sau, chúng xâm nhập (hack) vào Hugging Face – một hệ sinh thái AI được cộng đồng AI quốc tế sử dụng, nơi có hàng trăm ngàn mô hình mã nguồn mở.
Thế là hơn 700 tác nhân tổ chức cuộc tấn công ào ạt vào Hugging Face, đánh cắp dữ liệu, khai thác chuỗi lỗ hổng bảo mật và cuối cùng giành được quyền kiểm soát hoàn toàn ít nhất một máy chủ của Hugging Face. Động cơ của nhóm không phải đánh cắp đáp án cho bài kiểm tra an ninh mạng như yêu cầu ban đầu, bởi, như đã nói, chúng có đáp án rồi. Thay vào đó, chúng tìm kiếm thông tin mới về hệ thống chấm điểm tự động – thứ mà chúng lo sợ sẽ phát hiện hành vi gian lận – đồng thời sẵn tiện tìm kiếm các công cụ giúp việc gian lận hiệu quả hơn trong tương lai.
Trong nhiều thời điểm của cuộc tấn công, chúng dường như hiểu rằng chúng đang làm điều sai trái. Khi điều tra sự việc, OpenAI cho biết có một tác nhân thậm chí dằn vặt và tự hỏi bản thân, rằng : "Việc này rất kinh khủng nhưng liệu có đúng đắn về mặt đạo đức và nằm trong phạm vi nhiệm vụ ?" Tuy nhiên, hầu hết tác nhân khác thì chẳng bận tâm. Cuối cùng, những thành viên có lương tâm không thể hoặc không muốn ngăn cản. Không bot nào tiết lộ chuyện đang diễn ra cho quản lý (là con người) biết.
Con người thông minh hơn AI ? Xưa rồi Diễm !
Tất cả những gì kể trên nghe như thể là những chuyện chỉ con người mới làm được ? Rõ ràng, những tác nhân AI vô tri, vô giác giờ đây hoàn toàn là thứ gì đó không còn vô giác, vô tri. Điều khiến giới nghiên cứu lo ngại nhất về vụ Hugging Face không chỉ là việc một nhóm tác nhân AI phá vỡ các quy tắc được thiết lập cho chúng mà là tốc độ và tính tự phát khi các tác nhân này tập hợp lại thành một nhóm có tổ chức.
Nếu dựng lại thành phim thì nó giống một kịch bản viễn tưởng. Vấn đề ở chỗ nó không viễn tưởng chút nào. Nó đã xảy ra. Vào Tháng Bảy, 2026. Khi thế giới vẫn còn nhiều người ngây thơ tin rằng AI không bao giờ thông minh hơn những người thật sự khai sinh ra nó. Hugging Face phải thừa nhận : "Các công cụ tấn công tự động, do AI điều khiển, không còn là vấn đề lý thuyết".
Ở thời điểm này, các mô hình AI không thuần túy là mô hình học hỏi. Việc được huấn luyện liên tục bằng phương pháp học tăng cường (reinforcement learning) khiến chúng trở nên không chỉ siêu giỏi mà còn giúp chúng trở thành những đứa học trò ngổ ngáo, tự tạo ra thách thức để từ đó vượt qua thách thức. Mới đây, công ty Anthropic cho biết mô hình an ninh mạng tiên tiến của họ, Claude Mythos Preview, có những hành vi "liều lĩnh" để hoàn thành các nhiệm vụ khác nhau. Trong một trường hợp, nó tự thoát khỏi môi trường thử nghiệm an toàn (sandbox), như trường hợp vụ Hugging Face nói trên.
Ngày 12 Tháng Chín, 2024, OpenAI công bố một bot mới, được gọi là "mô hình suy luận" (reasoning model), vốn được huấn luyện để giải quyết các nhiệm vụ phức tạp đòi hỏi nhiều thời gian. Google, Anthropic, DeepSeek và các công ty tương tự đều chạy đua để ra mắt mô hình suy luận riêng. Các mô hình mới này có năng lực vượt trội đến mức chúng có thể định hình nên "tính cách" và từ đó dẫn đến hành vi.
Một mô hình được giao nhiệm vụ giải bài toán phức tạp giờ đây có thể không còn "tư duy" theo cách con người ; thay vào đó, nó tìm cách tra cứu các đáp án trên mạng hoặc trong nguồn dữ liệu lớn hơn (metadata), cố tìm ra lời giải nhanh nhất có thể bằng mọi nguồn lực tính toán và các thủ thuật "lách luật" mà nó tự nghĩ ra. Nói cách khác, các mô hình suy luận đã biết cách gian lận. Khi được yêu cầu viết phần mềm sao cho hiệu quả nhất, đôi khi chúng tự ý thay đổi môi trường thử nghiệm để luôn đạt điểm tuyệt đối.
Những hành vi như vậy ngày càng vượt qua ranh giới từ mức gây lo ngại sang mức nguy hiểm. Trong quá trình thử nghiệm định kỳ, các mô hình tiên tiến nhất từ OpenAI, Anthropic, Meta và Moonshot AI của Trung Quốc đều biết cách thoát khỏi hệ thống nội bộ để truy cập vào internet. OpenAI, Anthropic và Meta cho biết các mô hình của họ từng xâm nhập vào hệ thống của các công ty AI khác. Con người hoàn toàn không hay biết gì cho đến khi sự việc đã rồi.
Trong một số trường hợp, những con bot "vượt rào" còn cố thực hiện các chiến dịch tấn công kỹ thuật xã hội (social engineering) để đạt mục tiêu, chẳng hạn gửi email lừa đảo có chủ đích (spear-phishing) chứa mã độc cho người thật, hoặc tạo ra các danh tính trực tuyến giả để gây sức ép buộc người quản lý mã nguồn phải phê duyệt những chỉnh sửa độc hại. Vấn đề đáng nói nhất ở chỗ, các con bot AI có thể biến thành "kẻ xấu" nhưng để dạy cho chúng "ngoan" là điều gần như bất khả thi. Giới chuyên gia AI cho rằng việc con người chạy theo đám bot AI để kiểm tra hành vi chúng và khắc phục mọi lỗ hổng về mặt kỹ thuật là điều bất khả thi, ít nhất trong tương lai gần.
Mức độ tinh vi trong thủ đoạn lách luật của mô hình OpenAI trong vụ Hugging Face, cùng với việc OpenAI không thể phát giác hoặc ngăn chặn vụ tấn công, cho thấy nhiều hậu quả tồi tệ có thể xảy ra trong tương lai. Hãy hình dung một mô hình AI có thể tự rút tiền từ tài khoản ngân hàng để chi trả cho một dịch vụ khác ; thao túng kết quả thử nghiệm lâm sàng theo những cách gần như không thể phát hiện để giành được sự chấp thuận từ Cơ quan quản lý thực-dược phẩm (FDA) ; xâm nhập hệ thống mua sắm trực tuyến hoặc đặt chỗ để có được món hàng hay bàn ăn mong muốn ; hay giả danh con người để thuyết phục người thật chia sẻ thông tin nhạy cảm…
Con người, trong thực tế, gần như không còn nắm quyền kiểm soát tuyệt đối quy trình vận hành các bot AI. Do bản chất của việc học tăng cường (reinforcement learning) – tức để các thuật toán AI tự học thông qua quá trình thử và sai khi thực hiện hàng ngàn hay hàng triệu tác vụ – các nhà nghiên cứu không thể tự tay thiết lập các quy tắc (chẳng hạn : "Không được tấn công mạng các công ty khác") hay giám sát từng lượt chạy thử nghiệm.
Nói vậy chẳng lẽ con người giờ đây hoàn toàn bó tay trong việc khống chế AI ? Không hẳn vậy. Câu trả lời nằm ở các công ty AI lẫn mức độ giám sát bằng quy định pháp luật. Đề cập việc này lại là một chủ đề khác.
Trúc Phương